O guia completo de busca com IA no OJS
O que avaliar antes de ativar a busca com IA no OJS: corpus delimitado, citações verificáveis, operação, privacidade e perguntas que sua revista deve responder.
O guia completo de busca com IA no OJS
A busca com IA no OJS pode ajudar um leitor a fazer perguntas sobre o acervo publicado de uma revista. Para ser útil em um contexto acadêmico, ela deve mostrar de quais artigos sai a resposta, limitar-se ao corpus autorizado e deixar claro o que não pode responder.
Não se trata de colocar um chat genérico ao lado de uma revista. Trata-se de projetar uma camada de recuperação e consulta que respeite os limites editoriais.
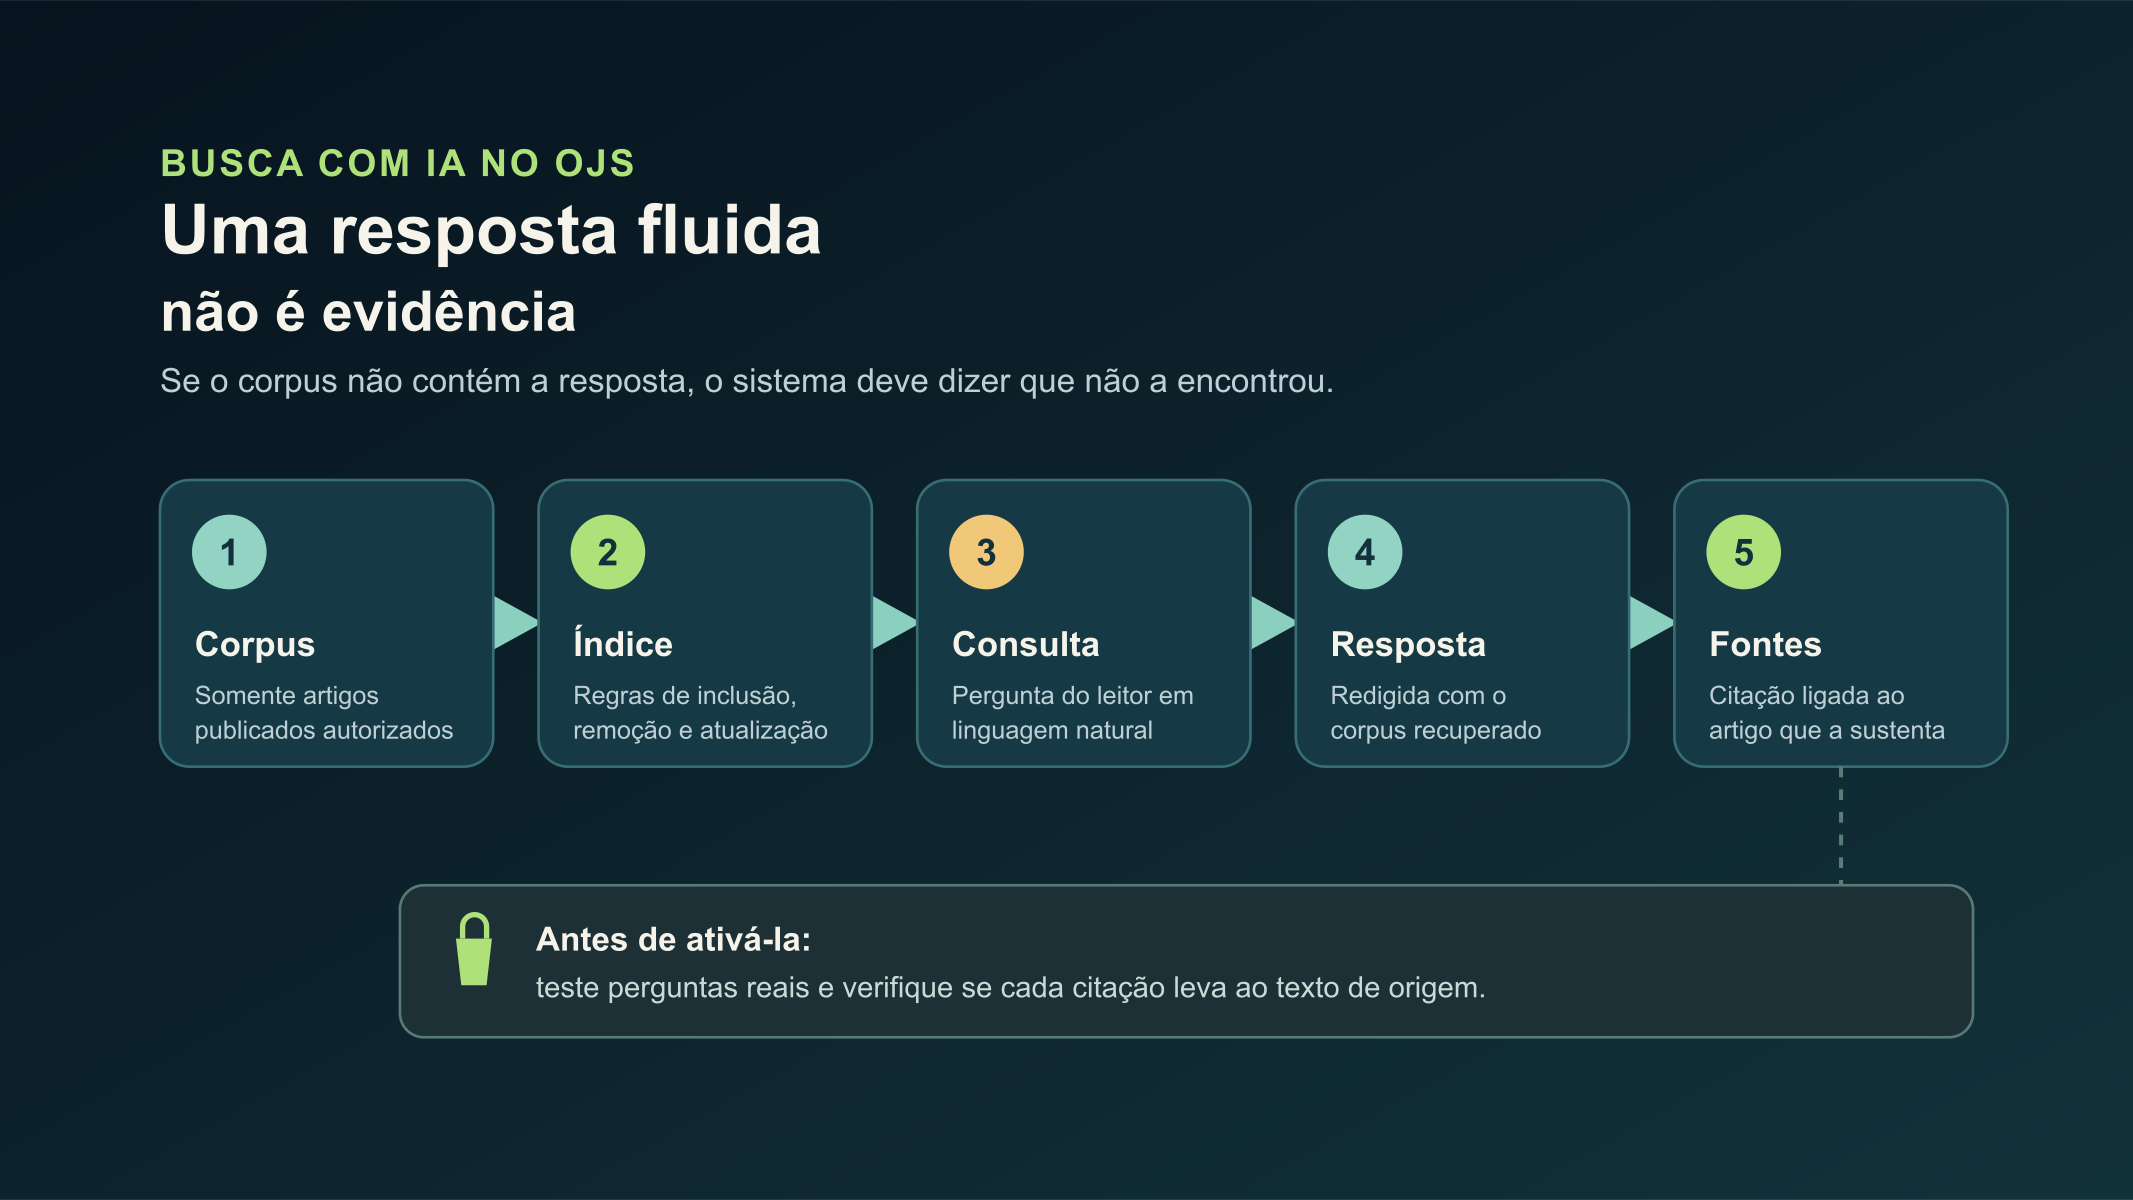
Diagrama próprio. Uma resposta de IA só é útil para uma revista se cada afirmação puder ser rastreada até um artigo publicado.
Que problema a busca com IA pode resolver
A busca tradicional devolve resultados por palavras e filtros. Uma camada de IA pode interpretar uma pergunta em linguagem natural e recuperar trechos relevantes antes de redigir uma resposta. Essa abordagem é útil quando o leitor não conhece os termos exatos usados pelos autores ou precisa conectar resultados distribuídos em vários artigos.
Mas uma resposta fluida não é evidência por si só. A implementação deve permitir que o leitor chegue aos artigos que sustentam cada afirmação.
O requisito central: corpus delimitado e rastreabilidade
Antes de avaliar uma ferramenta, defina quais documentos ela poderá consultar: artigos publicados, edições completas, suplementos, preprints ou material editorial. Não misture conteúdo publicado com manuscritos em revisão, comunicações internas ou informações de usuários.
A página do Lumen declara que opera sobre os artigos publicados pela revista, sem acessar fontes externas, e que suas respostas ligam citações diretas a artigos publicados.[1] Essa é uma capacidade declarada pela OJS ONE que deve ser comprovada em uma demonstração, com perguntas e citações reais, antes de incorporá-la a um portal.
A rastreabilidade deve incluir, no mínimo, título do artigo, autoria, ano, volume ou número e link para o texto. Se a resposta não puder mostrar suas fontes, deve ser considerada uma interface de exploração, não uma referência acadêmica.
Como funciona uma camada RAG em termos operacionais
RAG significa geração aumentada por recuperação. O processo pode ser descrito assim:
- indexam-se documentos autorizados;
- o leitor faz uma pergunta;
- o sistema recupera trechos potencialmente pertinentes;
- um modelo redige uma resposta usando esse contexto;
- a interface entrega links ou citações para verificação.
A documentação da PKP descreve um plugin como um componente que estende a funcionalidade básica do OJS e pode adicionar campos, alterar templates ou salvar informações novas.[2] Isso não demonstra que qualquer instalação tenha busca semântica nem que uma integração seja automática. Cada implementação precisa revisar a versão do OJS, a forma de indexar conteúdos, as permissões e o lugar onde as respostas são exibidas.
Perguntas a fazer antes de ativá-la
Que conteúdo entra no índice?
Exija uma lista de fontes e um processo para excluir artigos retratados, versões substituídas ou conteúdos que não devem aparecer. Defina quando o índice é atualizado após uma publicação e como se corrige um metadado errado.
Como as fontes são exibidas?
Faça testes com perguntas factuais e controversas. A resposta deve ligar ao artigo que realmente a sustenta, não apenas a uma página geral da revista.
Que dados chegam a provedores externos?
Esclareça se a consulta do leitor, os trechos recuperados ou os metadados saem da infraestrutura institucional. Revise contratos, retenção, controles de acesso e tratamento de informações. Não alimente uma camada de IA com manuscritos submetidos à avaliação se não houver autorização e um desenho específico para isso.
O que acontece quando não há evidência suficiente?
O sistema deve poder dizer que não encontrou informação no corpus, em vez de completar uma resposta com conhecimento geral. Essa condição é tão importante quanto a qualidade de uma resposta positiva.
Integração com o fluxo editorial
A busca com IA começa depois de publicar, não durante a avaliação. Antes de indexar, a revista precisa de conteúdos estáveis, metadados consistentes e links que se mantenham. Por isso, a decisão se relaciona com o trabalho prévio de produção e publicação, mas não o substitui.
Em um portal OJS, convém separar responsabilidades: a equipe editorial decide o que é publicado e indexado; quem opera a plataforma revisa disponibilidade, atualizações e permissões; quem entrega a ferramenta documenta suas fontes, limites e suporte. Administração do OJS: tarefas e evidências para portais de revistas oferece um marco útil para essa atribuição.
Erros comuns
O primeiro erro é anunciar que a IA "elimina alucinações". Nenhuma interface deve fazer essa promessa. Um corpus delimitado e citações visíveis reduzem o risco e facilitam a verificação, mas não substituem a leitura do artigo de origem.
O segundo é medir o sucesso pela quantidade de perguntas. Uma consulta útil deve conduzir a evidência verificável e respeitar o escopo da revista.
O terceiro é usar a mesma configuração para uma revista de pesquisa e para um portal completo sem definir limites por publicação. O índice e a interface devem respeitar a organização editorial do site.
Perguntas frequentes
A busca com IA substitui a busca própria do OJS?
Não necessariamente. Ela pode complementar a busca por palavras e a navegação existentes para perguntas em linguagem natural.
Ela pode responder com base na internet inteira?
Depende do desenho. Para uma revista, convém distinguir claramente uma ferramenta limitada ao corpus publicado de um assistente web geral.
Serve para revisar manuscritos?
Não deve ser presumido. Este guia trata da consulta de conteúdo já publicado; manuscritos e revisão por pares exigem controles de confidencialidade diferentes.
Conclusão
A busca com IA no OJS faz sentido quando melhora o acesso ao acervo sem ocultar as fontes. Priorize corpus delimitado, citações verificáveis, regras de atualização e limites claros.
O OJS One Lumen é a camada de inteligência acadêmica declarada pela OJS ONE para consultar artigos publicados com respostas rastreáveis até sua fonte. Antes de habilitá-lo, solicite uma avaliação sobre o corpus e as condições de operação da sua revista.
Fontes
- OJS ONE, OJS One Lumen: Academic Intelligence Layer for OJS — consultado em 2026-10-26.
- PKP, OJS/OMP/OPS Plugin Guide and Inventory — consultado em 2026-10-26.