La guía completa de búsqueda con IA en OJS
Qué evaluar antes de activar búsqueda con IA en OJS: corpus delimitado, citas verificables, operación, privacidad y preguntas que debe responder tu revista.
La guía completa de búsqueda con IA en OJS
La búsqueda con IA en OJS puede ayudar a un lector a formular preguntas sobre el archivo publicado de una revista. Para que sea útil en un contexto académico, debe mostrar de qué artículos sale la respuesta, limitarse al corpus autorizado y dejar claro qué no puede responder.
No se trata de poner un chat genérico junto a una revista. Se trata de diseñar una capa de recuperación y consulta que respete los límites editoriales.
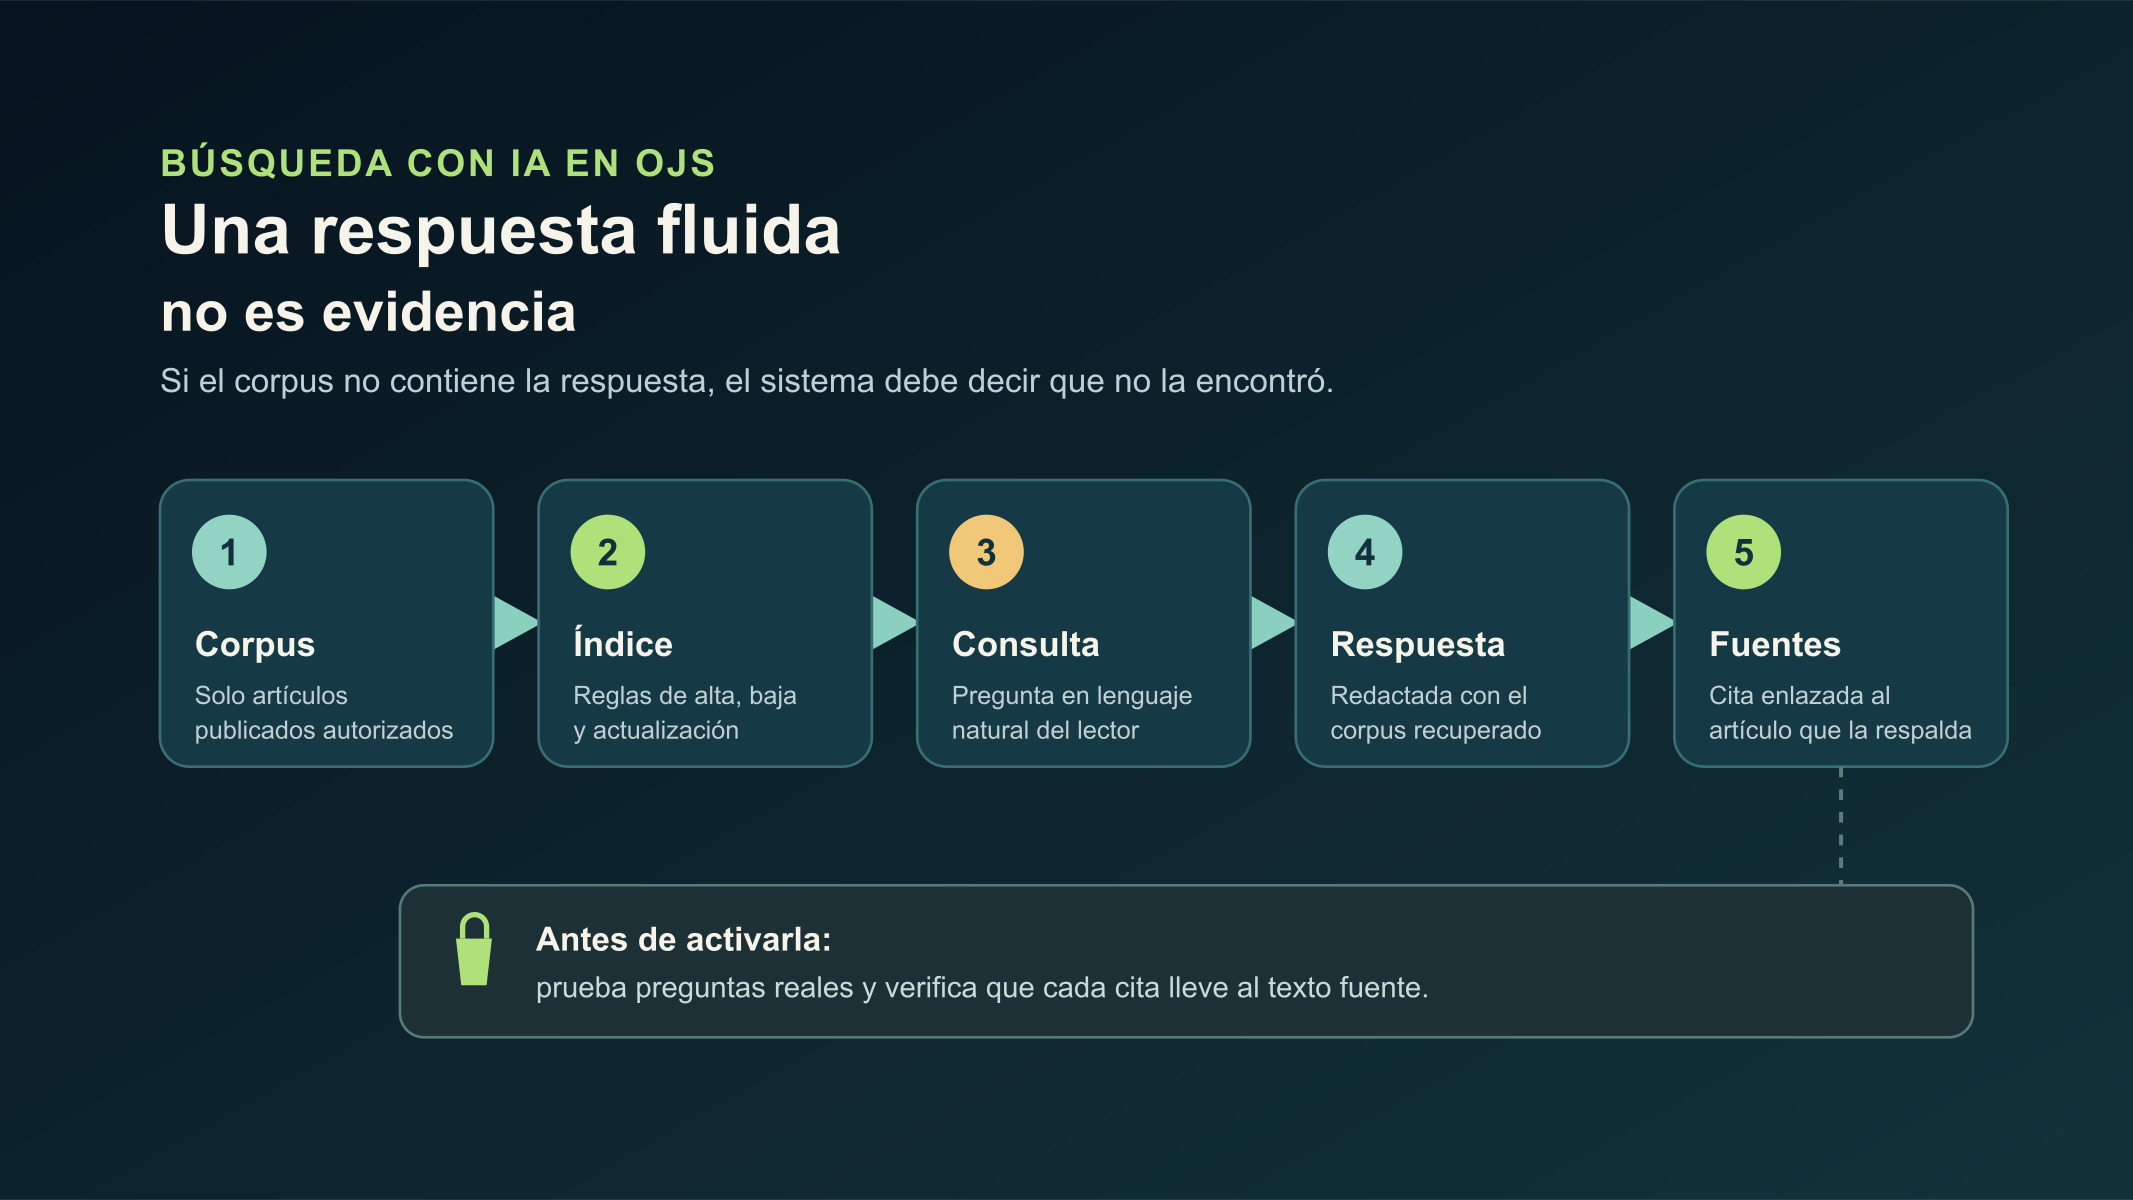
Diagrama propio. Una respuesta de IA solo es útil para una revista si cada afirmación se puede rastrear hasta un artículo publicado.
Qué problema puede resolver una búsqueda con IA
La búsqueda tradicional devuelve resultados por palabras y filtros. Una capa de IA puede interpretar una pregunta en lenguaje natural y recuperar fragmentos relevantes antes de redactar una respuesta. Ese enfoque es útil cuando el lector no conoce los términos exactos usados por los autores o necesita conectar resultados distribuidos en varios artículos.
Pero una respuesta fluida no es por sí misma evidencia. La implementación debe permitir que el lector llegue a los artículos que respaldan cada afirmación.
El requisito central: corpus delimitado y trazabilidad
Antes de evaluar una herramienta, define qué documentos podrá consultar: artículos publicados, números completos, suplementos, preprints o material editorial. No mezcles contenido publicado con manuscritos en revisión, comunicaciones internas o información de usuarios.
La página de Lumen declara que opera sobre los artículos publicados por la revista, sin acceder a fuentes externas, y que sus respuestas enlazan citas directas a artículos publicados.[1] Esa es una capacidad declarada por OJS ONE que debe comprobarse en una demostración con preguntas y citas reales antes de incorporarla a un portal.
La trazabilidad debe incluir, como mínimo, título del artículo, autoría, año, volumen o número y enlace al texto. Si la respuesta no puede mostrar sus fuentes, debe considerarse una interfaz de exploración, no una referencia académica.
Cómo funciona una capa RAG en términos operativos
RAG significa recuperación aumentada por generación. El proceso puede describirse así:
- se indexan documentos autorizados;
- el lector formula una pregunta;
- el sistema recupera pasajes potencialmente pertinentes;
- un modelo redacta una respuesta usando ese contexto;
- la interfaz entrega enlaces o citas para verificación.
La documentación de PKP describe que un complemento extiende la funcionalidad base de OJS y puede agregar campos, cambiar plantillas o guardar información nueva.[2] Eso no demuestra que cualquier instalación tenga búsqueda semántica ni que una integración sea automática. Cada implementación necesita revisar la versión de OJS, la forma de indexar contenidos, los permisos y el lugar donde se muestran las respuestas.
Preguntas que debes hacer antes de activarla
¿Qué contenido ingresa al índice?
Exige una lista de fuentes y un proceso para excluir artículos retirados, versiones reemplazadas o contenidos que no deben aparecer. Define cuándo se actualiza el índice tras una publicación y cómo se corrige un metadato erróneo.
¿Cómo se muestran las fuentes?
Haz pruebas con preguntas factuales y controversiales. La respuesta debe enlazar al artículo que realmente la sustenta, no solo a una página general de la revista.
¿Qué datos llegan a proveedores externos?
Aclara si la consulta del lector, los fragmentos recuperados o los metadatos salen de la infraestructura institucional. Revisa contratos, retención, controles de acceso y tratamiento de información. No alimentes una capa de IA con manuscritos sometidos a evaluación si no existe autorización y un diseño específico para ello.
¿Qué ocurre cuando no hay evidencia suficiente?
El sistema debe poder decir que no encontró información en el corpus, en vez de completar una respuesta con conocimiento general. Esa condición es tan importante como la calidad de una respuesta positiva.
Integración con el flujo editorial
La búsqueda con IA empieza después de publicar, no durante la evaluación. Antes de indexar, la revista necesita contenidos estables, metadatos consistentes y enlaces que se mantengan. Por eso la decisión se relaciona con el trabajo previo de producción y publicación, pero no lo reemplaza.
En un portal OJS, conviene separar responsabilidades: el equipo editorial decide qué se publica e indexa; quien opera la plataforma revisa disponibilidad, actualizaciones y permisos; quien entrega la herramienta documenta sus fuentes, límites y soporte. Administración OJS: tareas y evidencias para portales de revistas ofrece un marco útil para esa asignación.
Errores comunes
El primer error es anunciar que la IA “elimina alucinaciones”. Ninguna interfaz debe hacer esa promesa. Un corpus delimitado y citas visibles reducen el riesgo y facilitan la verificación, pero no reemplazan la lectura del artículo fuente.
El segundo es medir éxito por la cantidad de preguntas. Una consulta útil debe conducir a evidencia verificable y respetar el alcance de la revista.
El tercero es usar la misma configuración para una revista de investigación y para un portal completo sin definir límites por publicación. El índice y la interfaz deben respetar la organización editorial del sitio.
Preguntas frecuentes
¿La búsqueda con IA reemplaza la búsqueda propia de OJS?
No necesariamente. Puede complementar la búsqueda por palabras y navegación existente para preguntas en lenguaje natural.
¿Puede responder sobre internet completo?
Eso depende del diseño. Para una revista, conviene distinguir claramente una herramienta limitada al corpus publicado de un asistente web general.
¿Sirve para revisar manuscritos?
No debería asumirse. La guía trata consulta de contenido ya publicado; los manuscritos y la revisión por pares requieren controles de confidencialidad distintos.
Conclusión
La búsqueda con IA en OJS tiene sentido cuando mejora el acceso al archivo sin ocultar las fuentes. Prioriza corpus delimitado, citas verificables, reglas de actualización y límites claros.
OJS One Lumen es la capa de inteligencia académica declarada por OJS ONE para consultar artículos publicados con respuestas trazables a su fuente. Antes de habilitarla, solicita una evaluación sobre el corpus y las condiciones de operación de tu revista.
Fuentes
- OJS ONE, OJS One Lumen: Academic Intelligence Layer for OJS — consultado 2026-10-26.
- PKP, OJS/OMP/OPS Plugin Guide and Inventory — consultado 2026-10-26.
¿Tu revista actual sufre de lentitud o caídas constantes?
Contacta a nuestro equipo y descubre cómo una infraestructura de categoría empresarial puede transformar tu operación editorial.
Solicitar evaluación